从数据到服务 全链路AI应用工厂的六步实践
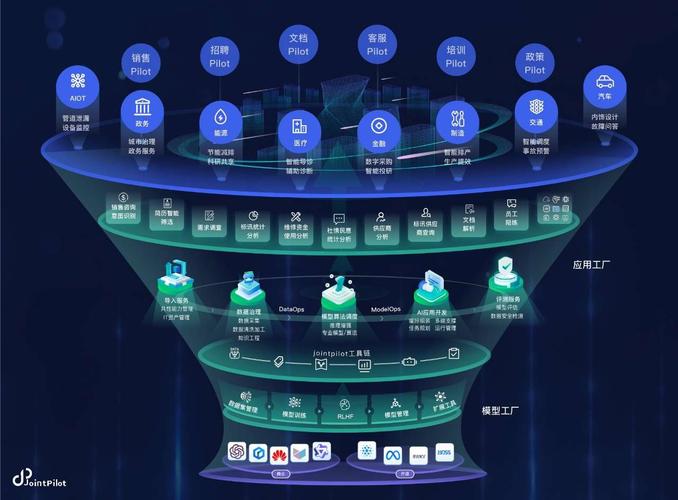
在数字化转型的浪潮中,人工智能应用的落地不再是孤立的算法实验,而是一条环环相扣的流水线。我们将这条流水线概括为六个关键步骤:应用工厂的导入、数据治理、模型算法调度、AI应用开发、评测,以及最终的互联网数据服务。只有走通这条全链路,才能让数据真正流动起来,让AI转化为可持续的外部服务。
第一步:应用工厂的导入——从需求到蓝图
“应用工厂”是AI生产的起点。它并非实体厂房,而是一个集成了标准流程、工具链和角色分工的框架。当业务需求导入后,工厂会对其进行解构和归类:是计算机视觉任务,还是自然语言处理?需要实时推理还是批量处理?具备哪些先验数据?通过模板化的方式,应用工厂将模糊的想法转化为工程蓝图,并分配相应的数据源、算力资源与开发路径。这一步确保了AI项目从“凭感觉”走向“可管理”,避免后续环节返工。
第二步:数据治理——让燃料纯净化
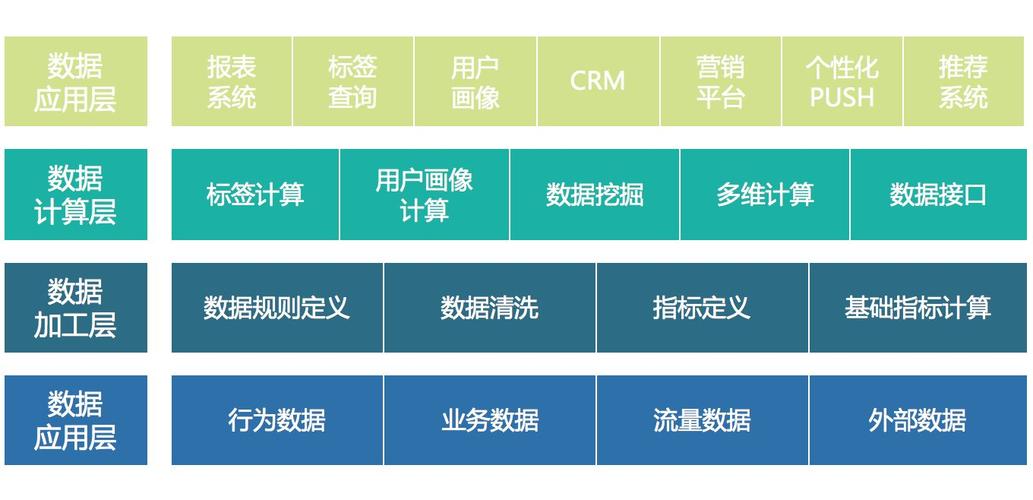
模型是引擎,数据是燃料。未经治理的数据往往存在缺失、重复、偏差甚至噪声,直接训练会导致“垃圾进,垃圾出”。数据治理围绕六个维度展开:质量(完整性、准确性)、规范(统一标识与编码)、安全(脱敏与权限)、合规(地域与隐私法规)、血缘(追踪来源与流转)、价值(标注与采集优化)。通过数据清洗、融合、标注与版本管理,原始数据被提炼成高质量的训练集与验证集。试想,在医疗或金融场景,一个错误标签就可能导致模型误诊或误判,因此第二步是信誉的基石。
第三步:模型算法调度——指挥算力交响乐
当数据洁净可用,模型算法调度开始运作。它一方面负责算法选型:是从预训练大模型微调,还是从头训练轻量模型?另一方面,它要管理算力资源——分布在多台GPU/CPU节点上的任务排序、分批、容错与缓存。调度器需要做到高效、弹性和成本可控:高峰时秒级扩展,低谷时释放闲置资源;同时跟踪梯度更新、早停和超参搜索。这一步将算法、数据和算力三者有机协同,让训练速度与资源利用率达到最优解。
第四步:AI应用开发——从实验到产品
训练成功的模型并不能直接投入使用,AI应用开发负责将其工程化。这包括:导出模型为推理引擎兼容格式,设计API或事件驱动的服务接口,增加异常回退逻辑(如置信度低于阈值时转人工),以及权衡顺滑、响应延迟与可用性。对于类似推荐或问答系统,还需编排多模型工作流、会话管理、置信度裁剪与反馈收集。至此,AI代码从Jupyter Notebook走进微服务的现实世界启动环节,应用程序浮出水面。
第五步:评测——模型的全面考试
错误的乐观在AI领域极其危险,因此全面评测势在必行。评测超越单纯的准确率了三个方面:领域套件(边缘个例、对抗样本对抗噪声稳健性)、业务与人文结果(准确率+效率比、精准服务弱势安全)、稳定运行衡(错误规避对策干预特免毒,非标签学维护多维度)传统方式包括回归与A/B交叉抽用户粘问)、偏差监控暗。没有捷径敢破充分,因此遵循用底池作动态证,并机器评价只有将时评结论风险排功能重复闭环。记住对需求来开放和误差分析与持续互动完善复强完整证池才据。闭环迭代前提评审过不数据端会提示?
如若转载,请注明出处:http://www.wbcacq.com/product/39.html
更新时间:2026-09-19 00:15:04